← Übersicht
Datenbanken

Was ist eine Datenbank?

Warum nicht einfach Excel?

Eine Datenbank speichert Daten strukturiert, sodass viele Benutzer und Programme gleichzeitig, sicher und widerspruchsfrei damit arbeiten können. Eine Excel-Tabelle stößt genau dort an Grenzen: Zwei Personen bearbeiten dieselbe Datei, jemand tippt „Wetzler“ statt „Wetzlar“, eine Zeile wird versehentlich gelöscht – und niemand merkt es.
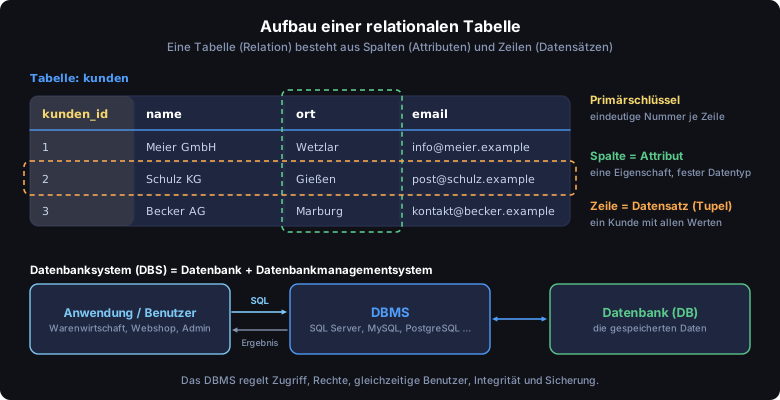
Aufbau einer Tabelle mit Primärschlüssel, Spalten und Zeilen sowie Zusammenspiel von Anwendung, DBMS und Datenbank
Abb. – Tabelle, Spalte, Zeile und das Zusammenspiel von Anwendung, DBMS und Datenbank

Die wichtigsten Begriffe

BegriffBedeutung
Datenbank (DB)Die eigentlich gespeicherten Daten.
DBMSDatenbankmanagementsystem – die Software, die die Daten verwaltet (z. B. Microsoft SQL Server, MySQL, PostgreSQL).
DBSDatenbanksystem = DB + DBMS.
Tabelle (Relation)Daten zu einem Thema, z. B. alle Kunden.
Spalte (Attribut)Eine Eigenschaft mit festem Datentyp, z. B. ort als Text.
Zeile (Datensatz, Tupel)Ein einzelner Eintrag, z. B. ein Kunde.
SchemaDer Bauplan: welche Tabellen, Spalten, Datentypen und Beziehungen es gibt.

Relationale und NoSQL-Datenbanken

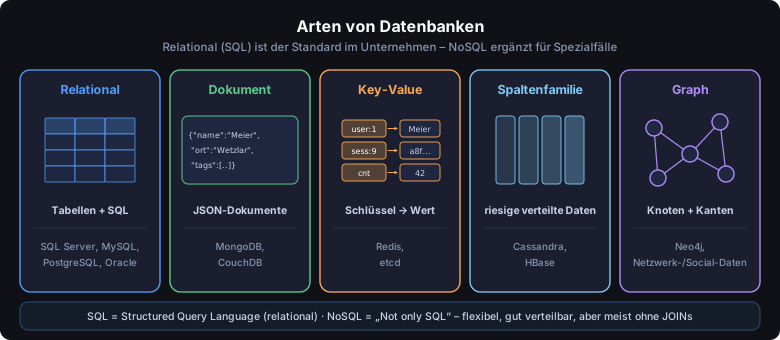
Fünf Arten von Datenbanken: relational, Dokument, Key-Value, Spaltenfamilie und Graph
Abb. – Datenbankarten mit typischen Vertretern
  • Relational – Daten in Tabellen, die über Schlüssel verbunden sind, Abfrage mit SQL. Standard für Warenwirtschaft, Buchhaltung, ERP, Personalverwaltung.
  • NoSQL – flexible Strukturen (Dokumente, Schlüssel/Wert, Graphen), gut auf viele Server verteilbar. Typisch für Web-Anwendungen, Caches (Redis) oder Konfigurationsspeicher (etcd in Kubernetes).
Für Admins: Auch ohne selbst zu programmieren begegnen dir Datenbanken überall – hinter dem Ticketsystem, der Warenwirtschaft, WSUS, dem Virenschutz-Server oder SharePoint. Du musst sie installieren, sichern, absichern und bei Problemen wiederherstellen können.
Datenbanken

ER-Modell & Beziehungen

Erst planen, dann bauen

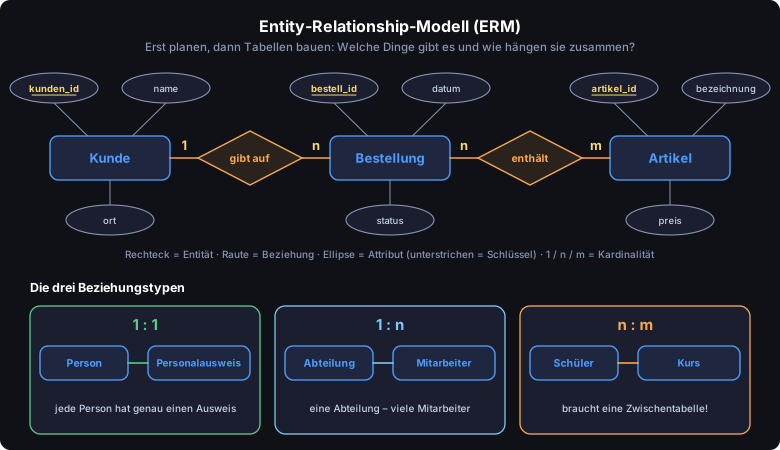
Bevor Tabellen angelegt werden, beschreibt man die Wirklichkeit mit einem Entity-Relationship-Modell (ERM): Welche „Dinge“ (Entitäten) gibt es, welche Eigenschaften (Attribute) haben sie und wie hängen sie zusammen (Beziehungen)?

ER-Diagramm Kunde gibt Bestellung auf, Bestellung enthält Artikel, darunter die Beziehungstypen 1:1, 1:n und n:m
Abb. – ER-Modell in Chen-Notation und die drei Beziehungstypen
KardinalitätBeispielUmsetzung in Tabellen
1 : 1Mitarbeiter ↔ FirmenwagenFremdschlüssel in einer der beiden Tabellen (mit UNIQUE) – oft auch eine gemeinsame Tabelle.
1 : nKunde ↔ BestellungenFremdschlüssel auf der „n“-Seite: bestellungen.kunden_id.
n : mBestellungen ↔ ArtikelEigene Zwischentabelle mit beiden Fremdschlüsseln (z. B. bestellpositionen).
Lesehilfe: Man liest die Kardinalität immer in beide Richtungen: „Ein Kunde gibt viele Bestellungen auf – eine Bestellung gehört zu genau einem Kunden.“ Daraus folgt 1 : n.
Datenbanken

Schlüssel & Integrität

Primärschlüssel

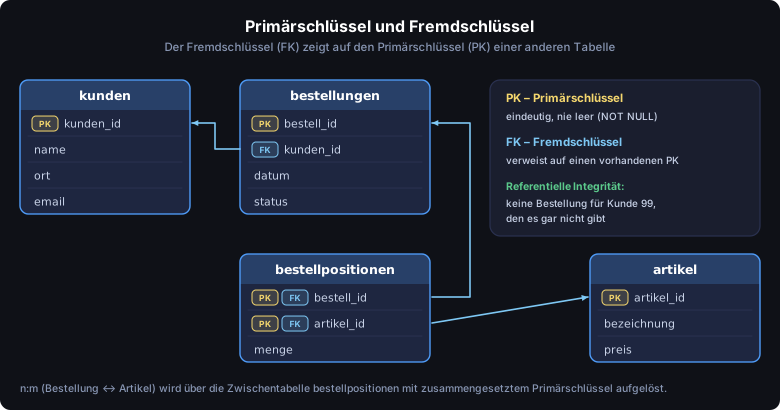
Der Primärschlüssel (Primary Key, PK) identifiziert jede Zeile eindeutig. Er darf nicht doppelt vorkommen und nie leer (NULL) sein. In der Praxis nimmt man meist eine fortlaufende Nummer ohne Bedeutung (Surrogatschlüssel, z. B. kunden_id) statt „natürlicher“ Werte wie E-Mail-Adresse oder Name – die können sich ändern.

Vier Tabellen kunden, bestellungen, bestellpositionen und artikel mit Primär- und Fremdschlüsseln
Abb. – Fremdschlüssel verbinden die Tabellen; die Zwischentabelle löst n : m auf

Schlüsselarten

SchlüsselBedeutung
Primärschlüssel (PK)Der gewählte eindeutige Schlüssel einer Tabelle.
Fremdschlüssel (FK)Spalte, die auf den Primärschlüssel einer anderen Tabelle verweist.
Zusammengesetzter SchlüsselPK aus mehreren Spalten, z. B. (bestell_id, artikel_id).
SchlüsselkandidatJede Spalte(nkombination), die eindeutig wäre – einer davon wird PK.

Referentielle Integrität

Das DBMS verhindert, dass ein Fremdschlüssel ins Leere zeigt: Eine Bestellung für Kunde 99 wird abgelehnt, wenn es Kunde 99 nicht gibt. Beim Löschen eines Kunden legt man fest, was mit seinen Bestellungen passiert:

  • ON DELETE RESTRICT / NO ACTION – Löschen wird verweigert, solange Bestellungen existieren (Standard).
  • ON DELETE CASCADE – Bestellungen werden mitgelöscht. Bequem, aber gefährlich.
  • ON DELETE SET NULL – der Fremdschlüssel wird geleert.
Datenbanken

Normalisierung

Jede Information nur einmal

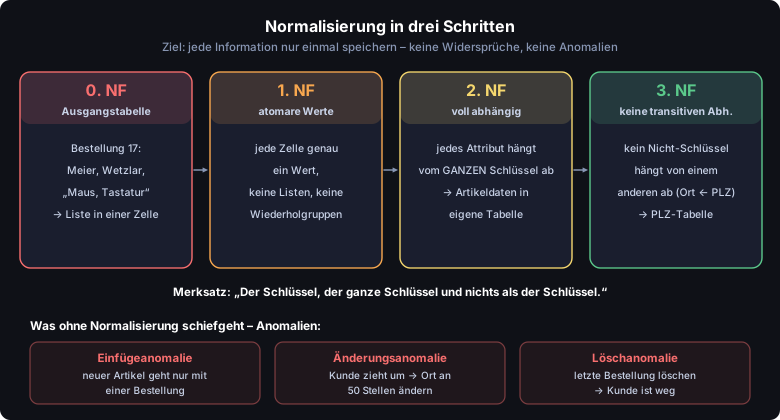
Normalisierung zerlegt eine große, unübersichtliche Tabelle schrittweise in mehrere kleine, sodass jede Information nur an einer Stelle gespeichert ist. Das verhindert Widersprüche – die sogenannten Anomalien.

Von der nicht normalisierten Tabelle über 1., 2. und 3. Normalform, darunter Einfüge-, Änderungs- und Löschanomalie
Abb. – Die drei Normalformen und die Anomalien, die sie verhindern

Beispiel Schritt für Schritt

Ausgangstabelle – alles in einer Tabelle:

bestell_idkundeplzortartikel
17Meier GmbH35578WetzlarMaus, Tastatur
  1. 1. NF – atomare Werte: „Maus, Tastatur“ ist eine Liste in einer Zelle. Daraus werden zwei Zeilen – je Artikel eine.
  2. 2. NF – volle Abhängigkeit vom Schlüssel: Der Schlüssel ist jetzt (bestell_id, artikel). Kunde und Ort hängen aber nur von bestell_id ab → Bestelldaten und Artikel kommen in getrennte Tabellen (bestellungen, bestellpositionen, artikel).
  3. 3. NF – keine transitiven Abhängigkeiten: ort hängt von plz ab, nicht vom Kunden direkt → Kundendaten in eine Tabelle kunden, Orte über die PLZ.
Praxis: In der Regel wird bis zur 3. Normalform normalisiert. Für Auswertungen (Data Warehouse, Berichte) wird bewusst wieder denormalisiert, weil weniger JOINs schneller sind.
Datenbanken

SQL-Überblick & Datentypen

Eine Sprache für alle relationalen Datenbanken

SQL (Structured Query Language) ist genormt (ISO/IEC 9075) und wird von allen relationalen Systemen verstanden. Jeder Hersteller hat zusätzlich einen eigenen Dialekt: T-SQL bei Microsoft SQL Server, PL/SQL bei Oracle, PL/pgSQL bei PostgreSQL. Die Grundbefehle sind überall gleich.

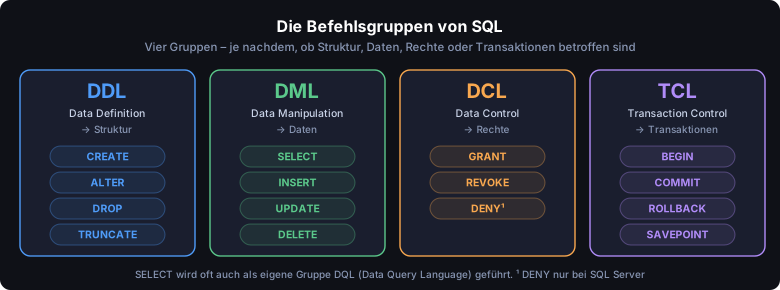
SQL-Befehlsgruppen DDL, DML, DCL und TCL mit ihren Befehlen
Abb. – Die vier Befehlsgruppen von SQL

Wichtige Datentypen

TypInhaltBeispiel
INT / BIGINTGanzzahlIDs, Mengen
DECIMAL(10,2)Exakte Kommazahl (10 Stellen, davon 2 Nachkommastellen)Preise – nie FLOAT für Geld!
VARCHAR(n)Text variabler Länge, max. n ZeichenNamen, E-Mail
CHAR(n)Text fester LängeLändercode „DE“
DATE / DATETIMEDatum bzw. Datum mit UhrzeitBestelldatum
BOOLEAN / BITWahr/falschaktiv ja/nein

Schreibregeln

  • Befehle enden mit einem Semikolon ;.
  • SQL-Schlüsselwörter sind nicht case-sensitiv – üblich ist GROSS für Befehle, klein für Tabellen und Spalten.
  • Texte stehen in einfachen Anführungszeichen: 'Wetzlar'.
  • Kommentare: -- bis Zeilenende oder /* mehrzeilig */.
  • NULL bedeutet „kein Wert“ – nicht 0 und nicht leerer Text.
Datenbanken

Tabellen anlegen (DDL)

CREATE TABLE

Mit DDL-Befehlen legt man die Struktur fest. Die Regeln (Constraints) gehören direkt in die Tabellendefinition – dann kann die Datenbank sie selbst überwachen.

CREATE TABLE kunden ( kunden_id INT PRIMARY KEY, name VARCHAR(100) NOT NULL, ort VARCHAR(60), email VARCHAR(120) UNIQUE ); CREATE TABLE bestellungen ( bestell_id INT PRIMARY KEY, kunden_id INT NOT NULL, datum DATE NOT NULL DEFAULT CURRENT_DATE, -- SQL Server: DEFAULT GETDATE() status VARCHAR(20) CHECK (status IN ('offen', 'versendet', 'storniert')), FOREIGN KEY (kunden_id) REFERENCES kunden(kunden_id) );

Constraints im Überblick

ConstraintWirkung
PRIMARY KEYeindeutig + NOT NULL
FOREIGN KEY … REFERENCESWert muss in der anderen Tabelle existieren
NOT NULLPflichtfeld
UNIQUEkein Wert doppelt (NULL meist erlaubt)
CHECKBedingung, z. B. preis >= 0
DEFAULTVorgabewert, wenn nichts angegeben wird

Ändern und Löschen

ALTER TABLE kunden ADD telefon VARCHAR(30); -- Spalte hinzufügen ALTER TABLE kunden DROP COLUMN telefon; -- Spalte entfernen DROP TABLE bestellungen; -- Tabelle samt Daten löschen TRUNCATE TABLE bestellungen; -- nur alle Zeilen leeren, Struktur bleibt
Achtung: DROP und TRUNCATE fragen nicht nach. In Produktivsystemen vorher sichern – und den Befehl erst auf einem Testsystem ausprobieren.

Automatisch hochzählende IDs heißen je nach System IDENTITY(1,1) (SQL Server), AUTO_INCREMENT (MySQL) oder GENERATED ALWAYS AS IDENTITY bzw. SERIAL (PostgreSQL).

Datenbanken

Daten abfragen (SELECT)

Grundform

SELECT name, ort -- welche Spalten (* = alle) FROM kunden -- aus welcher Tabelle WHERE ort = 'Wetzlar' -- welche Zeilen ORDER BY name ASC; -- Sortierung (ASC aufsteigend, DESC absteigend)

Filtern mit WHERE

OperatorBeispielBedeutung
= <> < > <= >=preis > 100Vergleich (<> = ungleich)
AND / OR / NOTort = 'Wetzlar' AND aktiv = 1verknüpfen
INort IN ('Wetzlar', 'Gießen')einer aus der Liste
BETWEENdatum BETWEEN '2026-01-01' AND '2026-03-31'Bereich inkl. Grenzen
LIKEname LIKE 'M%'Muster: % = beliebig viele Zeichen, _ = genau eins
IS NULLemail IS NULLkein Wert – = NULL funktioniert nicht!

Zählen, summieren, gruppieren

-- Anzahl Kunden pro Ort, nur Orte mit mehr als 5 Kunden SELECT ort, COUNT(*) AS anzahl FROM kunden GROUP BY ort HAVING COUNT(*) > 5 ORDER BY anzahl DESC;

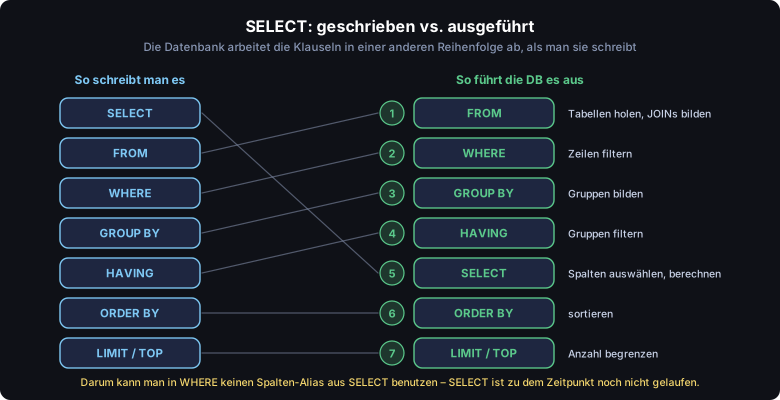
Aggregatfunktionen: COUNT(), SUM(), AVG(), MIN(), MAX(). WHERE filtert einzelne Zeilen vor dem Gruppieren, HAVING filtert die Gruppen danach.

Schreibreihenfolge der SELECT-Klauseln im Vergleich zur Ausführungsreihenfolge
Abb. – Die logische Ausführungsreihenfolge einer Abfrage

Weitere nützliche Bausteine

SELECT DISTINCT ort FROM kunden; -- jeden Ort nur einmal SELECT TOP 10 * FROM artikel ORDER BY preis DESC; -- SQL Server: die 10 teuersten SELECT * FROM artikel ORDER BY preis DESC LIMIT 10; -- MySQL / PostgreSQL -- Unterabfrage: Kunden, die noch nie bestellt haben SELECT name FROM kunden WHERE kunden_id NOT IN (SELECT kunden_id FROM bestellungen);
Datenbanken

JOINs – Tabellen verbinden

Warum JOINs?

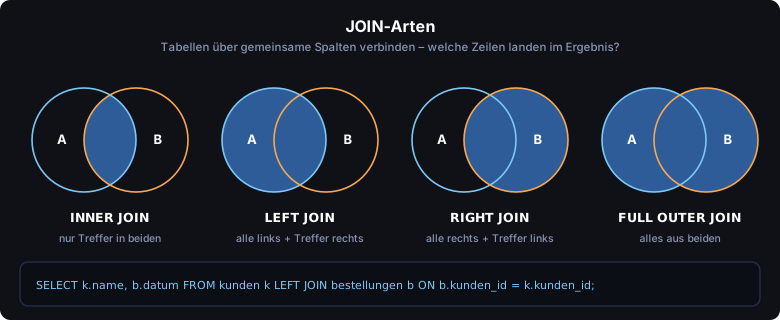
Durch die Normalisierung sind die Daten auf mehrere Tabellen verteilt. Ein JOIN setzt sie für eine Abfrage wieder zusammen – über die Spalten, die zusammengehören (meist Fremdschlüssel = Primärschlüssel).

Venn-Diagramme für INNER, LEFT, RIGHT und FULL OUTER JOIN
Abb. – Welche Zeilen bei welchem JOIN im Ergebnis landen
JOINErgebnisTypische Frage
INNER JOINnur Zeilen mit Treffer in beiden Tabellen„Welche Kunden haben bestellt – und was?“
LEFT JOINalle Zeilen links, rechts nur Treffer (sonst NULL)„Alle Kunden – auch die ohne Bestellung.“
RIGHT JOINumgekehrt: alle Zeilen rechtsselten – meist schreibt man es als LEFT JOIN
FULL OUTER JOINalle Zeilen aus beiden TabellenAbgleich zweier Listen
CROSS JOINjede Zeile mit jeder (kartesisches Produkt)fast nie gewollt

Beispiel über drei Tabellen

SELECT k.name, b.datum, a.bezeichnung, p.menge FROM kunden k JOIN bestellungen b ON b.kunden_id = k.kunden_id JOIN bestellpositionen p ON p.bestell_id = b.bestell_id JOIN artikel a ON a.artikel_id = p.artikel_id WHERE b.datum >= '2026-01-01';

k, b, p und a sind Aliase – Kurznamen für die Tabellen. JOIN ohne Zusatz ist ein INNER JOIN.

Typischer Fehler: Die ON-Bedingung vergessen oder falsch gesetzt → jede Zeile wird mit jeder kombiniert, aus 1.000 × 1.000 Zeilen werden 1 Million. Wenn eine Abfrage plötzlich riesige Ergebnisse liefert, zuerst die JOIN-Bedingungen prüfen.
Datenbanken

Daten ändern (INSERT, UPDATE, DELETE)

INSERT – neue Zeilen

INSERT INTO kunden (kunden_id, name, ort, email) VALUES (4, 'Wagner OHG', 'Limburg', 'info@wagner.example'); -- mehrere Zeilen auf einmal INSERT INTO artikel (artikel_id, bezeichnung, preis) VALUES (10, 'Maus', 19.90), (11, 'Tastatur', 39.90);

UPDATE – vorhandene Zeilen ändern

UPDATE kunden SET ort = 'Gießen', email = 'neu@meier.example' WHERE kunden_id = 1;

DELETE – Zeilen löschen

DELETE FROM bestellungen WHERE status = 'storniert' AND datum < '2025-01-01';
Die wichtigste Regel: Ein UPDATE oder DELETE ohne WHERE betrifft alle Zeilen der Tabelle. Profi-Gewohnheit: erst ein SELECT mit derselben WHERE-Bedingung ausführen, die Treffer prüfen – und die Änderung in einer Transaktion machen, damit ein ROLLBACK möglich bleibt.

DELETE, TRUNCATE oder DROP?

DELETETRUNCATEDROP
Was wird entfernt?ausgewählte Zeilenalle ZeilenTabelle komplett
WHERE möglich?janeinnein
Struktur bleibt?jajanein
Geschwindigkeitlangsam (jede Zeile protokolliert)sehr schnellsehr schnell
BefehlsgruppeDMLDDLDDL
Datenbanken

Views, Indizes & Prozeduren

View – die gespeicherte Abfrage

Eine View ist eine gespeicherte SELECT-Abfrage, die sich wie eine Tabelle benutzen lässt. Sie vereinfacht komplizierte JOINs und hilft beim Rechtemanagement: Ein Benutzer bekommt Zugriff auf die View, aber nicht auf die Tabelle mit allen Spalten.

CREATE VIEW v_kunden_umsatz AS SELECT k.name, SUM(p.menge * a.preis) AS umsatz FROM kunden k JOIN bestellungen b ON b.kunden_id = k.kunden_id JOIN bestellpositionen p ON p.bestell_id = b.bestell_id JOIN artikel a ON a.artikel_id = p.artikel_id GROUP BY k.name; SELECT * FROM v_kunden_umsatz WHERE umsatz > 1000;

Index – das Inhaltsverzeichnis

Ohne Index muss die Datenbank bei jeder Suche die ganze Tabelle lesen (Table Scan). Ein Index funktioniert wie das Stichwortverzeichnis eines Buches: Die Datenbank springt direkt zu den passenden Zeilen.

CREATE INDEX ix_kunden_ort ON kunden(ort);
  • Primärschlüssel bekommen automatisch einen Index.
  • Sinnvoll für Spalten, nach denen oft gesucht, sortiert oder gejoint wird (Fremdschlüssel!).
  • Nachteil: Jeder Index kostet Speicher und verlangsamt INSERT/UPDATE, weil er mitgepflegt werden muss.
  • Indizes fragmentieren mit der Zeit – Wartungspläne reorganisieren bzw. bauen sie regelmäßig neu auf.

Gespeicherte Prozeduren und Trigger

  • Stored Procedure – ein in der Datenbank gespeichertes Programm, z. B. EXEC sp_bestellung_anlegen 4, 10, 2;
  • Trigger – läuft automatisch bei INSERT, UPDATE oder DELETE, z. B. um jede Preisänderung in eine Protokolltabelle zu schreiben.
Datenbanken

Transaktionen & ACID

Alles oder nichts

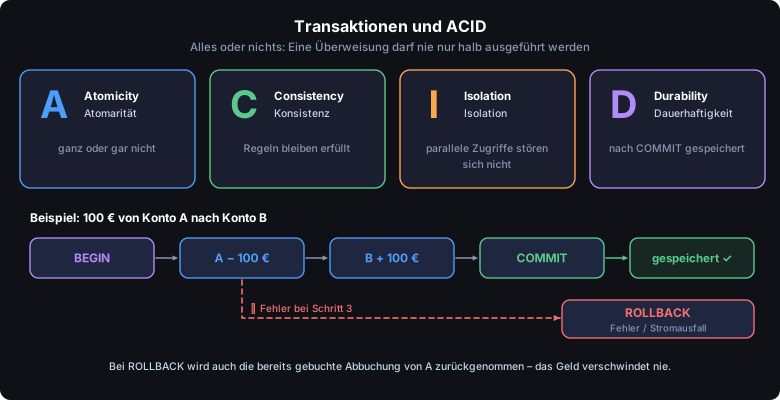
Eine Transaktion fasst mehrere Befehle zu einer Einheit zusammen. Entweder werden alle ausgeführt (COMMIT) oder keiner (ROLLBACK). Das garantieren die vier ACID-Eigenschaften.

Die vier ACID-Eigenschaften und eine Überweisung als Transaktion mit COMMIT bzw. ROLLBACK
Abb. – ACID am Beispiel einer Überweisung
BEGIN TRANSACTION; -- MySQL/PostgreSQL: START TRANSACTION; bzw. BEGIN; UPDATE konten SET saldo = saldo - 100 WHERE konto_id = 1; UPDATE konten SET saldo = saldo + 100 WHERE konto_id = 2; COMMIT; -- bei Fehler stattdessen: ROLLBACK;

Gleichzeitige Zugriffe: Sperren und Deadlocks

Damit sich parallele Transaktionen nicht in die Quere kommen, setzt die Datenbank Sperren (Locks) auf Zeilen oder Tabellen. Wie streng die Trennung ist, regelt das Isolation Level (von READ UNCOMMITTED bis SERIALIZABLE).

Ein Deadlock entsteht, wenn Transaktion A auf eine Sperre von B wartet und B gleichzeitig auf eine Sperre von A. Das DBMS erkennt das und bricht eine der beiden als „Opfer“ ab – die Anwendung muss sie erneut ausführen.

Admin-Tipp: Lange offene Transaktionen blockieren andere Benutzer und lassen das Transaktionsprotokoll wachsen. Bei „die Anwendung hängt“ lohnt sich ein Blick auf blockierende Sitzungen (SQL Server: sp_who2, Aktivitätsmonitor; PostgreSQL: pg_stat_activity; MySQL: SHOW PROCESSLIST).
Datenbanken

Benutzer, Rechte & SQL-Injection

Anmeldung und Benutzer

Am Beispiel Microsoft SQL Server: Ein Login gilt für den ganzen Server, ein Benutzer für eine einzelne Datenbank. Die Anmeldung erfolgt entweder per Windows-Authentifizierung (AD-Konto, empfohlen) oder per SQL-Authentifizierung (eigener Benutzername und Kennwort, z. B. sa).

Rechte vergeben (DCL)

-- Leserechte auf eine Tabelle GRANT SELECT ON kunden TO berichtsuser; -- Lesen und Schreiben, aber kein Löschen GRANT SELECT, INSERT, UPDATE ON bestellungen TO app_shop; -- Recht wieder entziehen REVOKE UPDATE ON bestellungen FROM app_shop;
  • Least Privilege: Jede Anwendung bekommt ein eigenes Konto mit genau den Rechten, die sie braucht – nie sa oder root.
  • Rechte über Rollen vergeben statt an einzelne Benutzer (wie AGDLP im Active Directory). SQL Server bringt z. B. db_datareader und db_datawriter mit.
  • Das Konto sa deaktivieren oder mit sehr langem Kennwort sichern und umbenennen.
  • Datenbankports (1433, 3306, 5432) niemals direkt ins Internet freigeben.

SQL-Injection

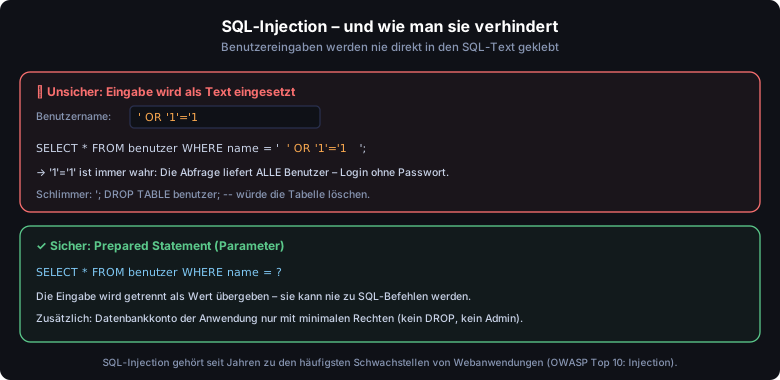
Unsichere Abfrage mit eingeschleustem OR 1=1 im Vergleich zu einem Prepared Statement
Abb. – So funktioniert SQL-Injection und so wird sie verhindert
Schutz: Prepared Statements (parametrisierte Abfragen) in der Anwendung, minimale Rechte für das Anwendungskonto, Eingaben prüfen und eine Web Application Firewall (WAF) vor öffentlichen Webanwendungen. Mehr zu Angriffen im Kapitel Cyber Security.
Datenbanken

Backup & Recovery

Warum ein normales Datei-Backup nicht reicht

Ein DBMS hält ständig Daten im Arbeitsspeicher und schreibt gleichzeitig in mehrere Dateien. Kopiert man die Datenbankdateien einfach im laufenden Betrieb, ist die Kopie oft inkonsistent und lässt sich nicht starten. Deshalb sichert man über die Datenbank selbst – oder mit einer Backup-Software, die das DBMS korrekt anspricht (bei Windows über VSS).

Daten- und Protokolldatei

  • Datendatei (SQL Server: .mdf) – die eigentlichen Tabellen.
  • Transaktionsprotokoll (SQL Server: .ldf, PostgreSQL: WAL, MySQL: Binlog) – jede Änderung wird zuerst hier notiert. Daraus kann die Datenbank nach einem Absturz den letzten konsistenten Stand wiederherstellen.
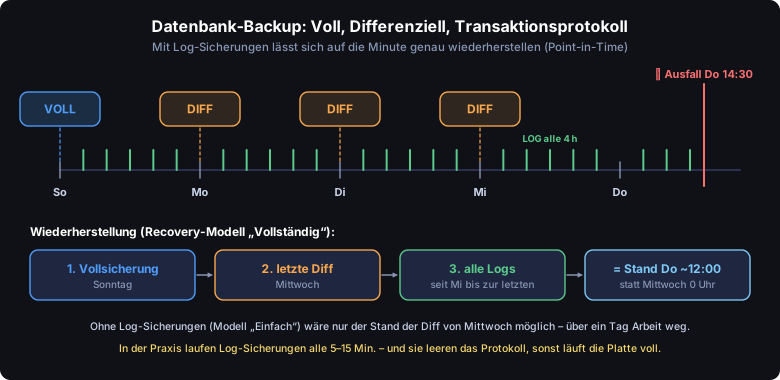
Zeitstrahl mit Voll-, Differenzial- und Log-Sicherungen und Wiederherstellungskette nach einem Ausfall
Abb. – Mit Log-Sicherungen auf einen bestimmten Zeitpunkt zurück (Point-in-Time-Restore)

Wiederherstellungsmodelle (SQL Server)

ModellLog-SicherungWiederherstellbar bisEinsatz
Einfach (Simple)nicht möglich, Log leert sich selbstletzte Voll-/Diff-SicherungTest, unkritische Daten
Vollständig (Full)ja, muss regelmäßig laufenbeliebiger ZeitpunktProduktivsysteme
Massenprotokolliertjameist bis zum Log-Backupvorübergehend bei großen Importen

Sicherungsbefehle

-- Microsoft SQL Server (T-SQL) BACKUP DATABASE Shop TO DISK = 'E:\Backup\Shop_full.bak' WITH CHECKSUM, COMPRESSION; BACKUP DATABASE Shop TO DISK = 'E:\Backup\Shop_diff.bak' WITH DIFFERENTIAL; BACKUP LOG Shop TO DISK = 'E:\Backup\Shop_log.trn'; RESTORE VERIFYONLY FROM DISK = 'E:\Backup\Shop_full.bak'; # MySQL / MariaDB $ mysqldump --single-transaction -u backup -p shop > shop.sql # PostgreSQL $ pg_dump -U backup -F c -f shop.dump shop $ pg_restore -U postgres -d shop shop.dump
Klassiker im Admin-Alltag: Datenbank im Modell „Vollständig“, aber nie eine Log-Sicherung eingerichtet → die .ldf-Datei wächst, bis die Platte voll ist und die Datenbank stehen bleibt. Entweder Log-Sicherungen planen oder bewusst auf „Einfach“ stellen. Und wie immer: Wiederherstellung regelmäßig testen.
Datenbanken

DBMS im Vergleich & Hochverfügbarkeit

Die verbreiteten Systeme

DBMSHersteller / LizenzStandardportWerkzeugeTypischer Einsatz
Microsoft SQL ServerMicrosoft, kommerziell (Express kostenlos, max. 10 GB je DB)TCP 1433SSMS, sqlcmd, PowerShellWindows-Umfeld, ERP, WSUS, SharePoint
MySQLOracle, Open Source (GPL) + kommerziellTCP 3306mysql, MySQL WorkbenchWebanwendungen (LAMP)
MariaDBCommunity-Fork von MySQL, Open SourceTCP 3306mariadb, HeidiSQLStandard in vielen Linux-Distributionen
PostgreSQLOpen SourceTCP 5432psql, pgAdminanspruchsvolle Anwendungen, GIS
Oracle DatabaseOracle, kommerziellTCP 1521SQL*Plus, SQL DeveloperGroßunternehmen
SQLitePublic Domain– (Datei)sqlite3eingebettet in Apps, Browser, Smartphones

Erste Befehle auf der Kommandozeile

C:\> sqlcmd -S SQL01\INSTANZ -E -Q "SELECT name FROM sys.databases" # SQL Server, Windows-Anmeldung $ mysql -u root -p -e "SHOW DATABASES;" # MySQL / MariaDB $ sudo -u postgres psql -c "\l" # PostgreSQL: Datenbanken auflisten

Hochverfügbarkeit

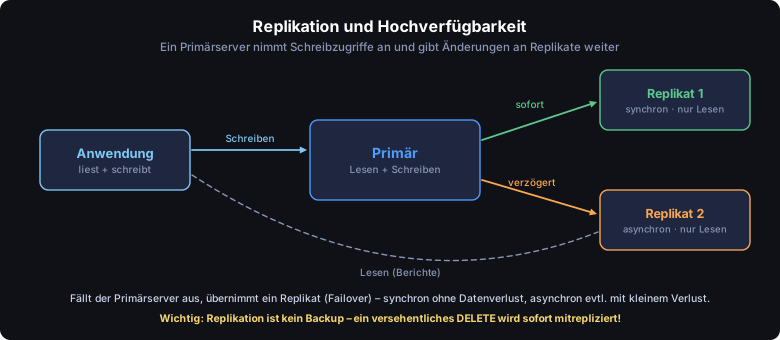
Primärserver repliziert synchron und asynchron auf zwei Replikate
Abb. – Replikation: ein Primärserver, mehrere Kopien
  • SQL Server: Always On Availability Groups, Failover Cluster Instance.
  • MySQL/MariaDB: Replikation (Quelle → Replikat), Galera Cluster.
  • PostgreSQL: Streaming Replication, Patroni für automatisches Failover.
Merke: Hochverfügbarkeit schützt vor dem Ausfall eines Servers, nicht vor Fehlern in den Daten. Ein versehentliches DELETE oder Ransomware wird sofort auf alle Replikate übertragen – Backups bleiben Pflicht.